Đội IT nhỏ không thiếu dữ liệu; điều họ thường thiếu là thời gian để biến dữ liệu thành hành động. Một hệ thống giám sát tinh gọn phải giúp trả lời nhanh bốn câu hỏi: dịch vụ nào đang suy giảm, ai bị ảnh hưởng, mức độ khẩn cấp ra sao và người nào cần xử lý. Nếu một chỉ số hoặc cảnh báo không hỗ trợ ít nhất một trong bốn câu hỏi này, nó chưa cần xuất hiện trên màn hình chính.
1. Tinh gọn không có nghĩa là giám sát ít
Giám sát tinh gọn không phải bỏ qua thiết bị hay chỉ kiểm tra hệ thống khi có sự cố. Điểm khác biệt nằm ở cách lựa chọn: đội ngũ chỉ thu thập những tín hiệu có liên hệ rõ với một dịch vụ quan trọng, một rủi ro cần theo dõi hoặc một quyết định vận hành.
Một doanh nghiệp có thể thu hàng nghìn chỉ số từ firewall, switch, access point, máy chủ, lưu trữ và ứng dụng cloud. Nhưng đội IT hai hoặc ba người không thể xem tất cả mỗi ngày. Màn hình chính vì vậy nên thể hiện trạng thái dịch vụ và mức độ ảnh hưởng; dữ liệu chi tiết chỉ được mở khi cần tìm nguyên nhân.
- Theo dõi để phát hiện và hành động, không phải để tích lũy thật nhiều biểu đồ
- Ưu tiên dịch vụ ảnh hưởng đến doanh thu, khách hàng và hoạt động hằng ngày
- Giữ dữ liệu chi tiết ở lớp phân tích thay vì đưa hết lên trang tổng quan
- Mỗi cảnh báo phải có người nhận và bước xử lý đầu tiên
2. Bắt đầu từ 3–5 dịch vụ thiết yếu
Thay vì lập danh sách mọi thiết bị đang có, hãy bắt đầu bằng những việc doanh nghiệp không thể để gián đoạn lâu: Internet và kết nối chi nhánh, Wi‑Fi văn phòng, ERP hoặc phần mềm bán hàng, email, tệp dùng chung, hệ thống máy chủ hoặc một ứng dụng cloud quan trọng.
Với mỗi dịch vụ, đội IT chỉ cần một bản đồ phụ thuộc đủ dùng: người sử dụng, thời gian cần hoạt động, đường truyền, thiết bị mạng, máy chủ hoặc cloud liên quan và nhà cung cấp chịu trách nhiệm. Bản đồ này giúp một cảnh báo kỹ thuật được đặt đúng bối cảnh. Mất một access point ở khu vực trống khác hoàn toàn với mất kết nối tại quầy giao dịch đang phục vụ khách hàng.
- Dịch vụ nào ảnh hưởng trực tiếp đến doanh thu hoặc khả năng phục vụ khách hàng?
- Nếu dịch vụ dừng 15 phút, một giờ hoặc nửa ngày thì ai bị ảnh hưởng?
- Dịch vụ phụ thuộc vào đường truyền, thiết bị, máy chủ và nhà cung cấp nào?
- Ai là người xác nhận trải nghiệm thực tế đã trở lại bình thường?
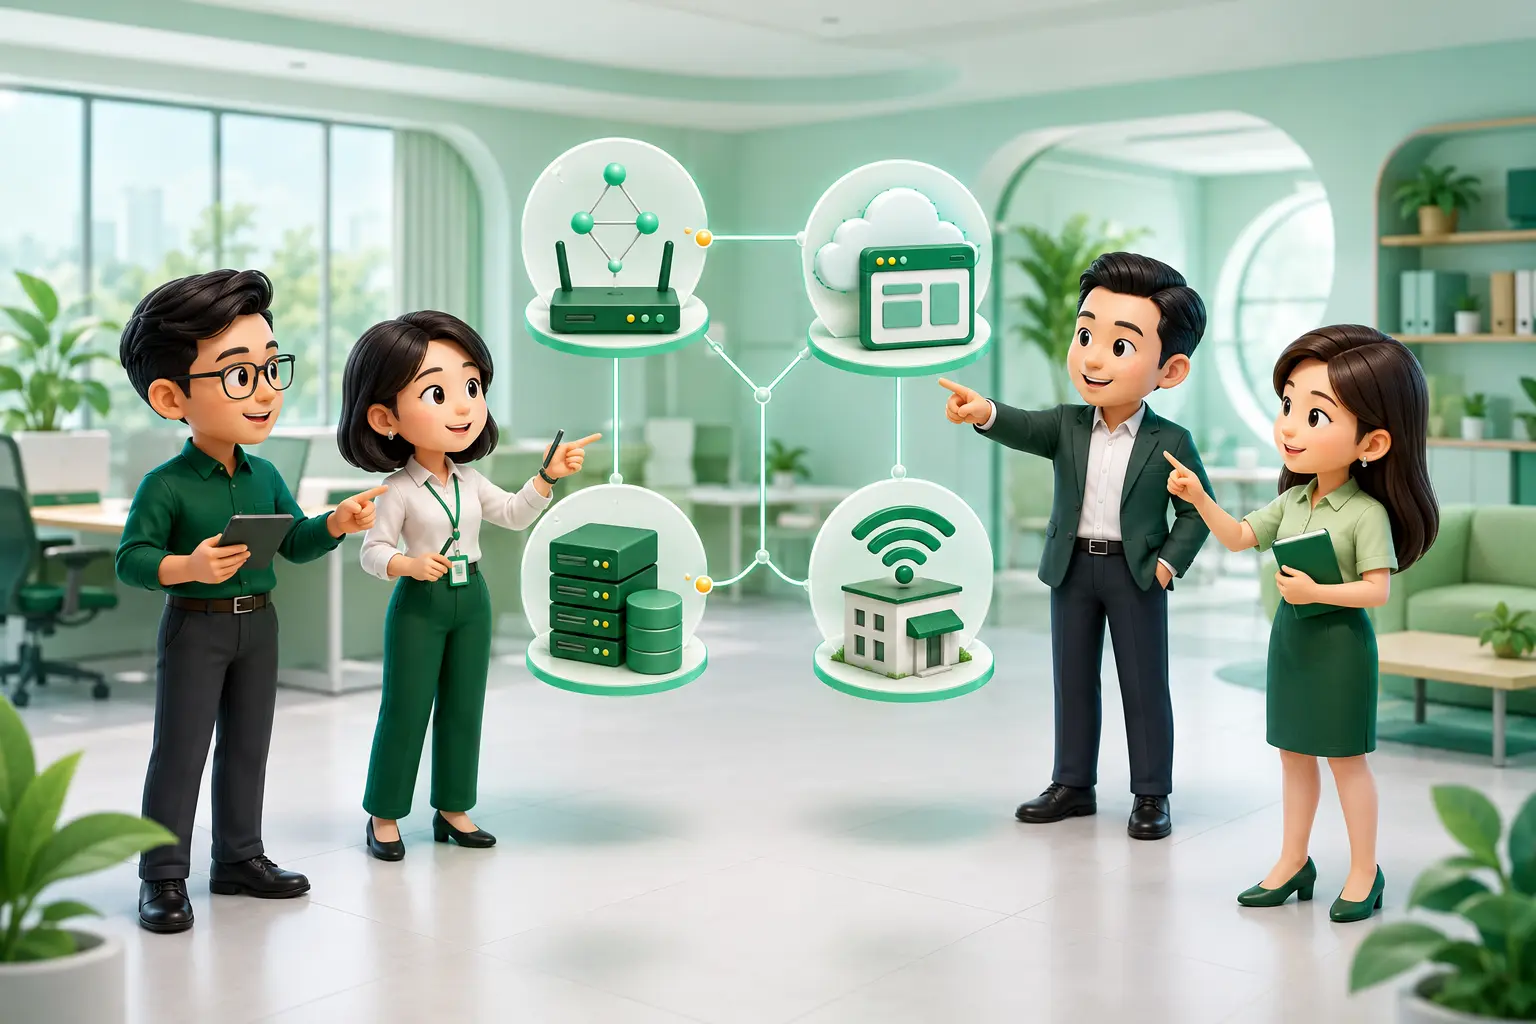
3. Bộ tín hiệu tối thiểu cho mỗi dịch vụ
Một bộ giám sát nhỏ nhưng hữu ích nên có ba lớp. Lớp thứ nhất là tính sẵn sàng: dịch vụ có truy cập được hay không. Lớp thứ hai là trải nghiệm: phản hồi có đủ nhanh và ổn định hay không. Lớp thứ ba là năng lực: tài nguyên có đang tiến gần giới hạn và cần lập kế hoạch hay không.
Ba lớp này bổ sung cho nhau. Một máy chủ vẫn phản hồi ping không có nghĩa ứng dụng hoạt động tốt; CPU tăng cao trong vài phút cũng chưa chắc là sự cố nếu thời gian phản hồi vẫn ổn định. Khi xem tín hiệu theo nhóm, đội IT phân biệt tốt hơn giữa biến động bình thường, suy giảm cần theo dõi và gián đoạn cần xử lý ngay.
- Sẵn sàng: trạng thái dịch vụ, đường truyền, thiết bị và tác vụ quan trọng
- Trải nghiệm: độ trễ, mất gói, thời gian phản hồi, tỷ lệ lỗi và chất lượng Wi‑Fi
- Năng lực: CPU, bộ nhớ, dung lượng, băng thông, số phiên và xu hướng tăng trưởng
- Vận hành: thời gian phát hiện, xác nhận, khôi phục và số lỗi tái diễn
4. Đặt ngưỡng theo đường cơ sở, không theo cảm tính
Một ngưỡng cố định áp dụng cho mọi hệ thống thường tạo quá nhiều cảnh báo hoặc bỏ sót thay đổi quan trọng. Đội IT nên thu thập dữ liệu trong hai đến bốn tuần để hiểu mức sử dụng bình thường theo giờ làm việc, cuối ngày, cuối tháng và các đợt cao điểm. Đây là đường cơ sở để nhận biết khi nào hệ thống thực sự lệch khỏi trạng thái quen thuộc.
Ngưỡng cũng cần thời gian duy trì. CPU vượt 85% trong vài giây có thể là bình thường, nhưng duy trì ở mức cao trong 15 phút cùng với phản hồi ứng dụng chậm lại thì đáng chú ý. Với dung lượng lưu trữ, xu hướng tăng và số ngày còn lại thường hữu ích hơn một tỷ lệ phần trăm đứng yên.
- Dùng hai mức: cảnh báo sớm để lên kế hoạch và cảnh báo khẩn để hành động
- Kết hợp giá trị, thời gian duy trì và mức ảnh hưởng thay vì chỉ dùng một con số
- Điều chỉnh theo khung giờ, mùa vụ và đặc điểm từng dịch vụ
- Rà lại ngưỡng sau mỗi thay đổi lớn về người dùng, đường truyền hoặc ứng dụng
5. Biến cảnh báo thành hàng đợi hành động
Cảnh báo chỉ có giá trị khi dẫn đến một hành động cụ thể. Đội IT nên chia tối thiểu ba mức: theo dõi, cần xử lý trong giờ làm việc và khẩn cấp. Mỗi mức cần nêu rõ kênh nhận, người chịu trách nhiệm, thời gian xác nhận và bước kiểm tra đầu tiên.
Để giảm nhiễu, hãy gộp các sự kiện có cùng nguyên nhân. Khi đường truyền chính mất, hàng chục thiết bị phía sau có thể đồng loạt báo không kết nối; người trực chỉ cần nhận một sự cố tổng hợp về đường truyền thay vì hàng chục thông báo riêng lẻ. Cảnh báo lặp lại nhưng không tạo hành động nên được điều chỉnh, hạ mức hoặc loại khỏi kênh khẩn cấp.
- Một cảnh báo phải thể hiện dịch vụ, vị trí, mức độ ảnh hưởng và thời điểm bắt đầu
- Gộp cảnh báo phụ thuộc để tránh một nguyên nhân tạo ra nhiều thông báo
- Chuyển đúng người: mạng, máy chủ, ứng dụng, nhà cung cấp hoặc quản lý nghiệp vụ
- Ghi nhận kết quả xử lý để nhận diện sự cố tái diễn và điều chỉnh ngưỡng
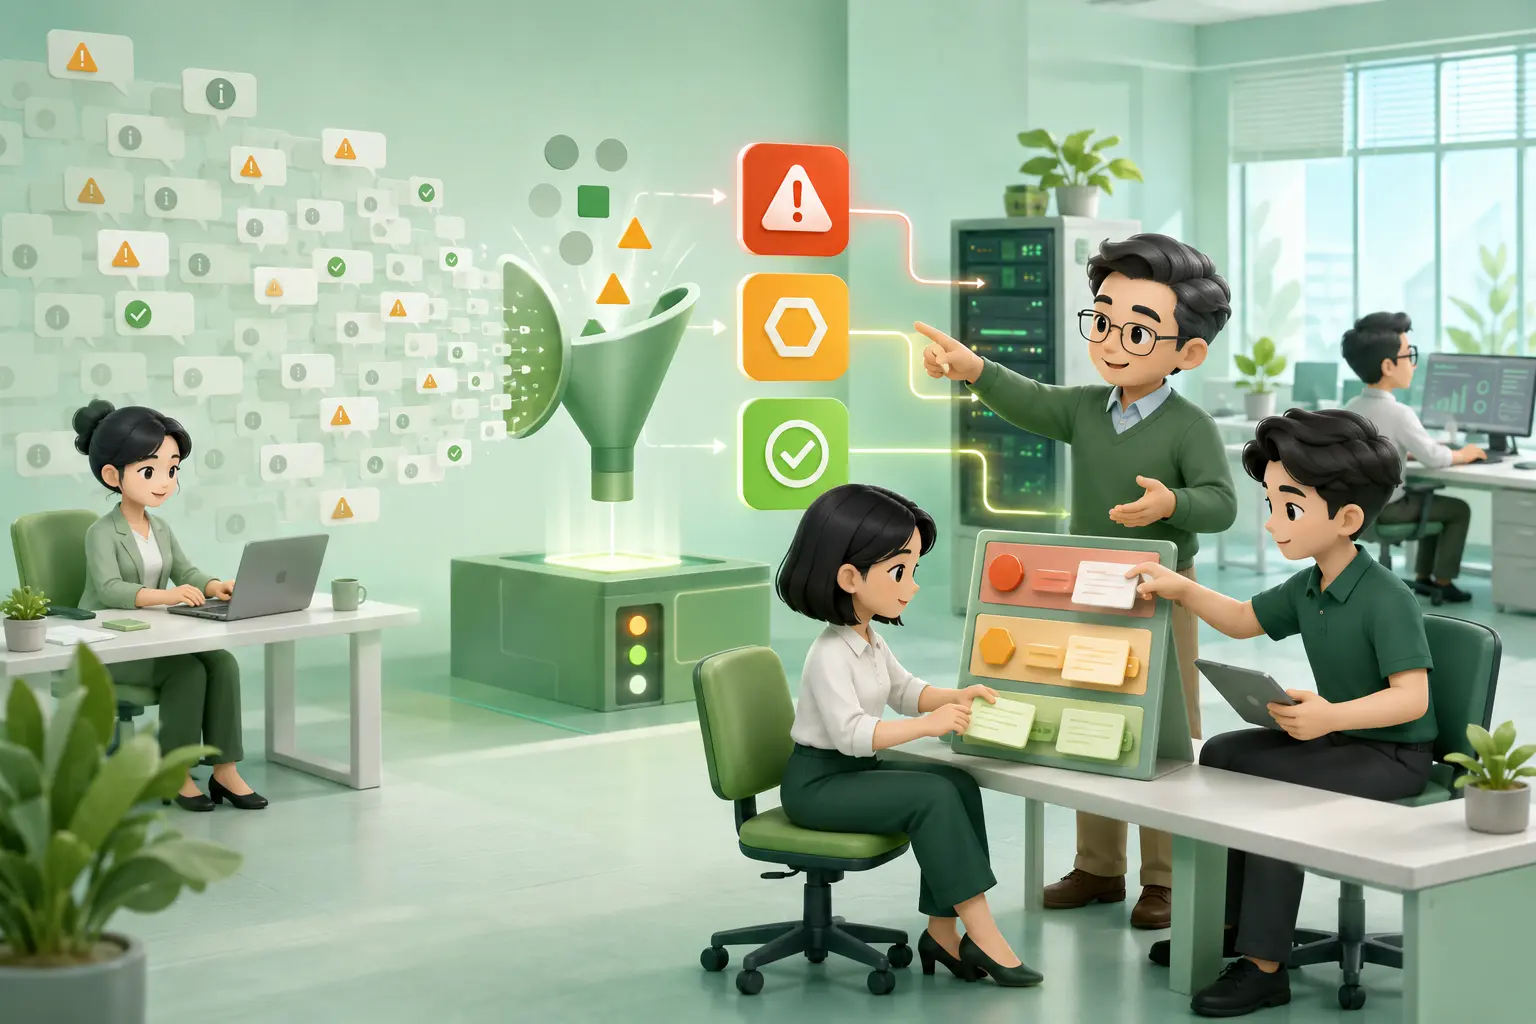
6. Một trang tổng quan cho từng vai trò
Kỹ thuật viên cần tín hiệu chi tiết để tìm nguyên nhân, nhưng quản lý vận hành cần biết dịch vụ nào đang ảnh hưởng đến người dùng và khi nào có thể khôi phục. Vì vậy, không nên dùng một trang tổng quan duy nhất cho tất cả. Một lớp điều hành ngắn gọn có thể hiển thị trạng thái dịch vụ, sự cố đang mở và xu hướng chính; lớp kỹ thuật giữ dữ liệu thiết bị, lưu lượng và nhật ký để phân tích sâu.
Báo cáo cũng nên tập trung vào xu hướng và quyết định. Thay vì chỉ nêu số lượng cảnh báo, hãy cho biết dịch vụ nào gián đoạn nhiều nhất, lỗi nào tái diễn, dung lượng nào sắp chạm giới hạn và hành động nào cần ngân sách hoặc phối hợp với nhà cung cấp.
- Màn hình trực ca: sự cố mới, mức độ, người nhận và thời gian chưa xử lý
- Màn hình kỹ thuật: tín hiệu chi tiết, phụ thuộc và dữ liệu phục vụ chẩn đoán
- Báo cáo quản lý: tính sẵn sàng, sự cố lớn, xu hướng năng lực và việc cần quyết định
- Không dùng màu đỏ cho mọi biến động; màu sắc phải phản ánh mức ưu tiên thực tế
7. Nhịp vận hành ngày – tuần – tháng
Giám sát chỉ tạo giá trị khi được đưa vào nhịp làm việc. Mỗi ngày, người phụ trách kiểm tra sự cố đang mở và các cảnh báo chưa được xác nhận. Mỗi tuần, đội IT rà lỗi lặp lại, xu hướng suy giảm và các cảnh báo gây nhiễu. Mỗi tháng, nhóm kỹ thuật cùng đại diện vận hành hoặc quản lý xem lại mức ổn định, năng lực và những khoản đầu tư cần chuẩn bị.
Nhịp ngắn giúp hệ thống không biến thành một màn hình bị bỏ quên sau khi triển khai. Nó cũng tạo dữ liệu đủ tin cậy để đội IT giải thích vì sao cần nâng đường truyền, thay thiết bị, điều chỉnh kiến trúc hoặc chưa cần đầu tư thêm.
- Hằng ngày: xử lý cảnh báo còn mở và xác nhận trạng thái dịch vụ
- Hằng tuần: rà lỗi lặp lại, cảnh báo nhiễu và thay đổi bất thường
- Hằng tháng: xem xu hướng năng lực, mức ổn định và công việc ưu tiên
- Hằng quý: đánh giá lại phạm vi giám sát theo thay đổi của doanh nghiệp
8. Lộ trình triển khai trong 30 ngày
Tuần đầu tiên, hãy chọn 3–5 dịch vụ thiết yếu, lập bản đồ phụ thuộc và thống nhất người phụ trách. Tuần thứ hai, kết nối các nguồn dữ liệu cơ bản và tạo đường cơ sở. Tuần thứ ba, thiết lập ngưỡng, phân mức cảnh báo và thử quy trình chuyển thông tin. Tuần cuối, loại bỏ tín hiệu không hữu ích, hoàn thiện trang tổng quan và chốt nhịp rà soát định kỳ.
Không cần đưa toàn bộ hạ tầng vào ngay từ đầu. Một phạm vi nhỏ hoạt động tốt sẽ chứng minh giá trị nhanh hơn một dự án lớn nhưng khó duy trì. Sau 30 ngày, chỉ mở rộng sang dịch vụ mới khi đội ngũ đã xử lý ổn định cảnh báo hiện có và có dữ liệu cho thấy phạm vi mở rộng thực sự cần thiết.
- Tuần 1: chọn dịch vụ, phạm vi, phụ thuộc và người phụ trách
- Tuần 2: thu thập dữ liệu và xác định trạng thái bình thường
- Tuần 3: đặt ngưỡng, phân mức và diễn tập luồng xử lý
- Tuần 4: giảm nhiễu, chốt báo cáo và lịch rà soát
Đi sâu hơn theo
đúng bài toán.
Gợi ý từ Arbolume: Hãy bắt đầu bằng khảo sát hiện trạng và mức độ ưu tiên. Một cấu hình vừa vặn thường hiệu quả hơn một giải pháp lớn nhưng khó vận hành.